AI新藥開發革命:人工智慧如何重塑藥物研發全流程?
內容摘要:人工智慧(AI)透過結合精準物理計算、高通量自動化實驗室及動態決策引擎,能從數十億候選分子中快速篩選並驗證活性藥物,使傳統需耗時數年的臨床前開發流程縮短至數月甚至數週,徹底重塑生醫產業新藥研發的決策與迭代模式。
本文由具備生醫科技與藥物研發背景的編輯團隊整理,並參考國內外生醫論壇公開資訊與專家觀點,旨在提供客觀且具深度之新藥研發趨勢分析。
Q1:為什麼傳統藥物研發流程需要AI的介入?
傳統的新藥開發流程一直面臨著所謂的「反摩爾定律」(Eroom’s Law),也就是藥物研發的資金與時間成本呈指數型上升,但最終的研發成功率卻不斷下滑。一般而言,開發一款全新的小分子藥物,平均需要耗時10至12年的漫長時間,且整體研發花費高達20億美元以上。如此高昂的成本與極低的成功率,使得生醫產業背負了沉重的財務壓力,也延遲了病患獲得新療法的契機。
在臨床前研發的初始階段,科學家必須在茫茫的化合物大海中進行篩選,尋找能與目標蛋白質靶點結合的潛在活性分子。傳統上,這需要化學家手動合成成百上千個分子,再透過生物化學實驗逐一進行測試。這種大海撈針的「試錯法」不僅效率極低,且極易因為人為操作誤差或實驗再現性不足而走進死胡同。
引進人工智慧後,研發團隊能夠在虛擬空間中進行海量的篩選工作。AI模型可以在極短的時間內,針對數十億甚至數百億個分子進行預測,大幅限縮了需要實際合成與測試的化合物範圍。這不僅能為藥廠節省龐大的早期篩選成本,更能將藥物發現的時程縮短數倍,這正是AI重塑藥物研發流程的核心價值所在。
Q2:物理計算與機器學習如何協同優化藥物分子篩選?
物理計算與機器學習結合如何發揮綜效?
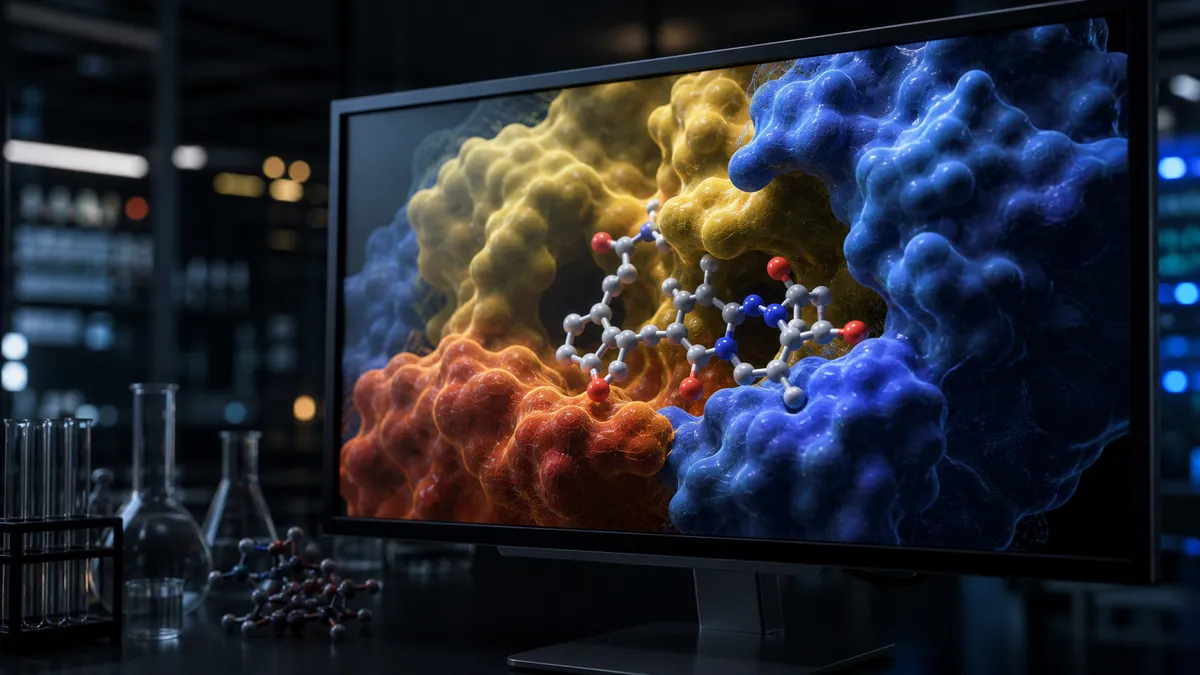
在AI藥物設計的應用中,機器學習(Machine Learning)無疑是一項強大的工具。然而,機器學習的預測精準度高度依賴於訓練數據的數量與質量。當面對一些全新發現、未被充分研究的蛋白質靶點時,由於缺乏充足的實驗數據,純粹的數據驅動模型往往會失效或產生嚴重的幻覺。此時,結合底層物理規律的物理計算便顯得至關重要。
物理計算主要利用量子力學(Quantum Mechanics)、分子動力學(Molecular Dynamics)以及自由能計算(Free Energy Calculation)等物理定律,在分子層面直接計算化合物與目標蛋白質靶點之間的結合力、溶解度、膜通透性及脫靶風險。這種不依賴歷史實驗數據的「第一性原理」預測,能為AI模型建立穩固的底層架構,使預測結果更具可信度。
根據生醫專家在2026年BIO Asia-Taiwan論壇的分享,國際計算藥物開發大廠在實際專案中將這兩種技術深度整合。例如在某個針對MALT1抑制劑的開發計畫中,研究團隊利用物理運算平台篩選了高達82億個分子,最終在運算模型的精準篩選下,僅合成了78個化合物,並在短短10個月內便成功取得了符合臨床前標準的候選藥物。這種結合物理計算與機器學習的模式,徹底突破了傳統篩選的瓶頸。
儘管運算模型能提供高度精準的預測,但專家也特別強調,AI藥物設計的最終驗證仍然在於臨床結果。無論是體外實驗還是電腦模擬的數據表現得再優異,候選藥物進入臨床試驗後展現的安全性與療效,才是檢驗AI價值的終極指標。因此,運算模型必須與生物學實驗緊密配合,透過臨床前的實際反饋持續修正參數。
Q3:自動化實驗室如何在藥物合成與測試中發揮關鍵作用?
自動化平台如何改變藥物研發的分工模式?
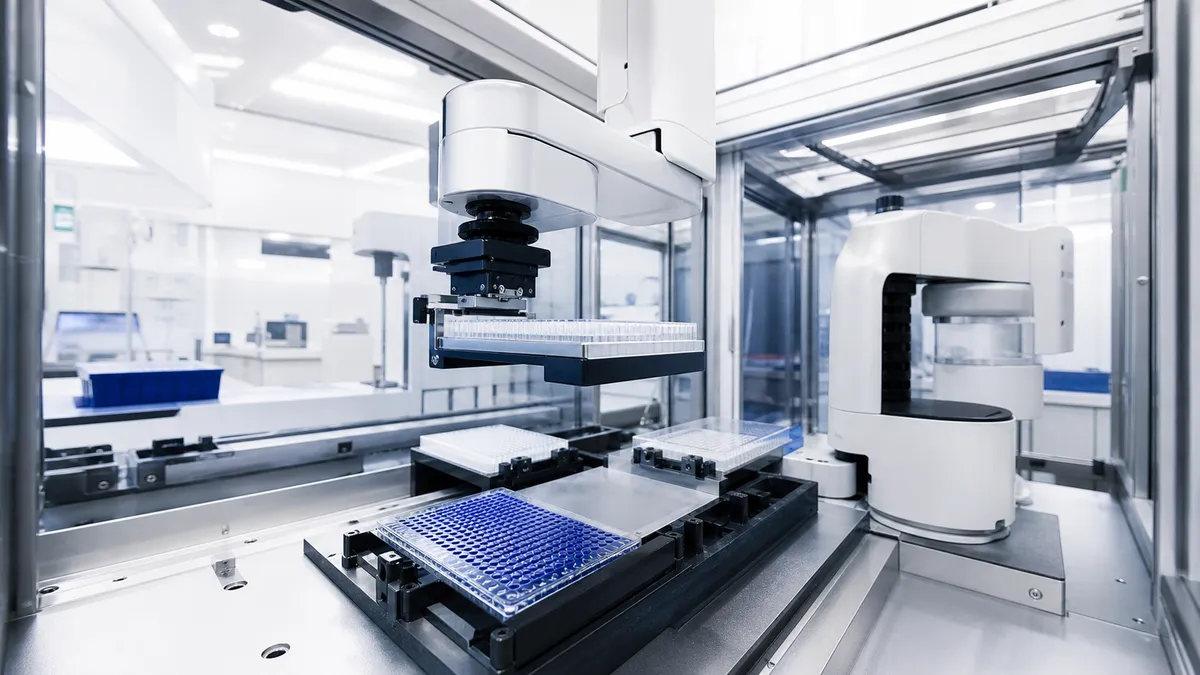
隨著AI與雲端運算的普及,藥物研發的分工模式正迎來顛覆性的轉變。傳統上,研究人員必須花費大量的時間在實驗桌旁進行手動的有機合成、配方開發與材料測試。而如今,這種高重複性且繁重的體力勞動正逐步轉交給全天候運作的高通量自動化實驗室,科學家的角色則轉化為負責設計假設與進行高階的決策判斷。
在先進的自動化實驗平台中,高精準度的機械手臂與自動化液體處理設備能進行24小時不間斷的實驗操作。根據產業實際運作數據顯示,自動化平台的實驗通量約為傳統人工操作的5至8倍。更為關鍵的是,自動化設備能嚴格控制每次實驗的參數與步驟,徹底消除因不同操作人員習慣所導致的實驗誤差,從而在源頭上確保了實驗數據的標準化與高度的一致性。
為什麼實驗資料庫的數據品質會影響AI的預測精準度?
AI模型是否能展現高超的預測能力,關鍵在於訓練資料的品質。生醫大廠的研究指出,如果純粹使用公開的學術資料庫來訓練模型,效果往往不如使用標準化自動實驗室所累積的專利數據。這是因為公開文獻中常存在著實驗再現性不足的問題,而且大多數發表的研究僅著重於報導「成功的結果」,而選擇性忽視了「失敗的實驗」。
在機器學習中,這些失敗的「陰性數據」(Negative Data)與成功數據同樣重要。如果AI模型只學習成功的案例,便無法識別化合物結構中的致命缺陷。因此,透過自動化實驗室持續累積百萬級的標準化計算與實驗數據,並將成敗紀錄完整保留,才能訓練出不帶偏見且高度精準的AI模型。
目前,自動化研發服務商已開發出智慧研發助理系統(如Genius AI Agent),協助科學家處理專利搜尋、背景整理、庫存查詢、可合成性分析以及設備參數設定等前置工作。該系統上線半年後,每月能處理的化合物數量從200個大幅飆升至5,000個以上。以GPX4活性的篩選為例,研發團隊先從8,000個分子中篩選出159個候選分子,再交由自動化平台進行快速合成與測試,最終僅耗時28天便成功找出了3個具備高活性的目標分子,驗證了AI與自動化實驗的高速迭代潛力。
Q4:AI決策引擎如何應用於複雜的RNA藥物開發?
為什麼決策品質比分子產出數量更為關鍵?
RNA(核糖核酸)藥物由於能從根本上調控基因表達,是近年來生醫產業的熱門研發方向。然而,RNA結構具有高度的動態性與複雜性,傳統藥物開發方法難以精準定位。雖然AI的引入使得分子生成的數量大增,但專家指出,研發團隊真正需要解決的並非「分子產量」,而是「決策品質」的提升。
在繁複的研發流程中,科學家必須精準判斷哪些數據值得信任、哪些分子具備合成的科學價值,以及每一次實驗結果該如何引導下一步的研究方向。如果這些底層的疾病假設或靶點判定出現偏差,單純提高分子的生成速度,只會加速把資源耗費在錯誤的方向上。因此,建構一套以「學習循環」為核心的AI決策引擎便顯得極為重要。
這種決策引擎的核心在於將預測模型、構效關係分析與自動化評分排序工具深度整合,形成設計(Design)、製造(Make)、測試(Test)與分析(Analyze)的DMTA閉環。在每一輪的循環中,不僅是成功的陽性數據,連同失敗的陰性數據都會被轉化為優化模型的養分,從而讓下一次的分子設計更加精確,這正是大幅降低臨床前階段錯誤率的關鍵所在。
AI在RNA剪接療法中有哪些具體的應用案例?
在具體的研發實踐中,創新RNA療法研發企業正致力於利用小分子調控RNA剪接,進而降解帶有毒性外顯子的轉錄本,以阻斷致癌蛋白質的生成。以轉錄因子MYB為標的的研發計畫中,團隊藉由AI決策引擎輔助設計出A25先導候選產品系列。
在臨床前的動物模型驗證中,以口服給藥方式針對大腸直腸癌小鼠進行測試,結果成功達到了40%的腫瘤生長抑制效果,且初步觀察到的耐受性與安全性表現良好。這一具體成果證明了以持續學習為核心的AI決策引擎,確實能引導研發團隊少走彎路,精準地將運算結果轉化為具備臨床前價值的實體藥物分子。
Q5:AI輔助藥物研發與傳統研發模式有何不同?
為了解答讀者對於這兩種研發範式的疑問,以下表格將傳統研發模式與AI輔助藥物研發在關鍵維度上的差異進行了系統性的對比:
| 比較維度 | 傳統藥物研發模式 | AI輔助藥物研發模式 |
|---|---|---|
| 分子篩選機制 | 依賴人工手動合成與逐一體外篩選,效率較低。 | 利用機器學習與物理計算在虛擬空間進行數十億分子篩選。 |
| 數據依賴與品質 | 偏重公開學術文獻中的成功數據,再現性參差不齊。 | 依賴高通量自動化實驗室所累積的標準化專利數據。 |
| 陰性數據應用 | 文獻鮮少報導失敗實驗,模型難以學習錯誤規律。 | 高度重視陰性(失敗)數據,將其作為模型修正的重要養分。 |
| 實驗操作與通量 | 受限於實驗室人工工時與操作誤差,通量有限。 | 自動化平台24小時運作,通量可達人工操作的5至8倍。 |
| 臨床前研發時程 | 從靶點發現到取得候選藥物,平均需要3至6年。 | 藉由虛擬篩選與快速迭代,可將時程縮短至1至2年內。 |
| 決策優化模式 | 依賴科學家個人經驗進行試錯與判斷。 | 結合預測模型與DMTA閉環系統,持續優化決策品質。 |
從上述對比可以看出,AI輔助研發不僅僅是「速度的提升」,更是「研發思維的典範轉移」——從盲目的經驗試錯,演進為由高品質數據與物理運算雙重驅動的精密科學決策。
常見問題 (FAQ)
1. AI真的能完全取代科學家進行新藥開發嗎?
不行。AI在藥物研發中的角色定位是「高效的協作工具」與「決策輔助引擎」,而非取代科學家。雖然AI能夠處理數十億分子的超高速運算,並優化分子設計,但生醫領域中極其複雜的系統生物學機制、臨床轉譯可行性評估,以及最終的人體臨床試驗設計,仍然必須仰賴具備豐富經驗的科學家與臨床醫師進行嚴謹的判斷與把關。
2. 為什麼在AI藥物開發中「失敗的數據」(陰性數據)如此重要?
因為AI模型需要同時理解「對的結構」與「錯的結構」,才能做出準確的預測。如果僅使用公開文獻中報導的成功案例(陽性數據)來訓練模型,AI會因為樣本偏差而高估分子的成功率,甚至重複合成具有潛在結構缺陷的分子。納入失敗的陰性數據能讓AI學會辨識脫靶風險與溶解度瓶頸,使篩選模型更加精準。
3. AI藥物研發在通過監管機構(如FDA)審查時面臨哪些挑戰?
主要挑戰在於AI預測模型的「黑盒子問題」(即缺乏可解釋性)以及臨床轉譯的真實表現。各國監管機構如美國食品藥物管理局(FDA)與中華民國衛生福利部(衛福部)等,在審查新藥時要求必須具備清晰的作用機制與明確的安全數據。因此,AI開發出的化合物不論運算預測多完美,仍必須通過嚴格的體外實驗、動物模型驗證及人體臨床試驗,以真實的科學證據來說服監管機構。
4. 什麼是物理計算?它與一般的機器學習有何差別?
機器學習是透過既有的實驗數據進行統計學上的模式識別,其精準度受限於歷史數據的完整性。而物理計算(例如量子力學與分子動力學模擬)則是直接依據物理學的第一性原理,計算分子與蛋白質原子之間的物理相互作用力。在缺乏歷史實驗數據的新靶點開發上,物理計算能提供可信的預測基礎,與機器學習形成完美的互補。
5. AI在RNA藥物開發中扮演著什麼角色?
由於RNA分子結構具有高度的動態量性與複雜摺疊特徵,傳統篩選方法很難找到有效的靶向小分子。AI決策引擎可以精準模擬小分子與RNA動態三維結構的結合模式,並預測其對RNA剪接機制的調控效果。這能幫助科學家設計出精準降解特定致病蛋白質轉錄本的化合物,為腫瘤學及遺傳性罕見疾病的治療開闢全新的路徑。
免責聲明
本文僅供一般資訊參考,不構成醫療專業建議。讀者於做出任何具體決定前,應諮詢合格的醫師與專業醫療人員。