Gemini Omni 生成影片有多強?文字、圖片、音訊與影片混合生成完整解析
核心重點提要:Google 在 2026 年 5 月推出震撼業界的 Gemini Omni,宣告多模態 AI 進入全新紀元。這款模型打破以往限制,能完美將文字、圖片、影片與音訊無縫混合,一鍵生成高品質影音內容。本實測報告將帶您深入了解其圖片轉影片的角色一致性、精準的音畫同步技術,以及如何透過自然語言進行高效率的 AI 影片編輯,讓您搶先掌握未來的生成式影音趨勢與 Google Flow 整合應用。
為什麼 Gemini Omni 被譽為 2026 年最強的多模態 AI?
根據我們編輯團隊的深度實測與觀察,Gemini Omni 的最大突破在於其「原生多模態」的理解架構。在過去,所謂的 AI 影片生成往往是將流程拆解:先用一個模型生成圖像,再用另一個模型處理動態,最後人工對齊音訊。這樣的流程不僅耗時,還經常導致角色變形或音畫不同步的窘境。
然而,這款強大的工具能夠在同一個運算階段中,同時消化劇本文字、場景概念圖與對白音訊。這意味著,它在規劃每一格畫面時,都已經將音頻的波形與節奏考量進去,使得生成的成品擁有令人驚豔的連貫性。許多影音從業人員在測試後都驚呼,這將大幅改變未來的影視製作生態。
突破傳統限制:它如何實現精準的音畫同步?
音畫同步一直是生成式影音的一大難題。我們特別準備了一段充滿節奏感的背景音樂以及一段人聲配音進行測試。結果顯示,它能夠根據音訊的高低起伏與人聲的嘴型,自動微調影片中人物的唇部動作,甚至讓環境的光影跟著音樂的節拍閃爍。
這種深度的同步能力,是因為模型在訓練時學習了海量的視聽資料關聯性。您只需要提供素材,剩下的就交給 AI 去感受與生成,大幅節省了在傳統剪輯軟體中逐格微調的時間。
文字、圖片與音訊混合生成:我們如何進行極限實測?
為了驗證其實力,我們設計了幾種極端的測試情境,從純文字到複雜的圖片轉影片任務,全面考驗這款 AI 的穩定性與創意空間。
測試一:我們如何挑戰繁體中文提示詞與場景建構?
我們首先使用全繁體中文輸入了一段複雜的科幻場景描述:「一艘閃爍著藍光的太空船,正緩慢降落在充滿紅色植被的未知行星上,狂風捲起漫天紅沙。」令人印象深刻的是,Gemini Omni 不僅完美理解了繁體中文的語意,還精準還原了藍光、紅色植被與狂風等細節元素,畫面流暢度直逼好萊塢特效水準。
測試二:圖片轉影片如何通過角色一致性考驗?
在過去,AI 影片編輯最怕的就是每一秒長得都不一樣。我們上傳了一張手繪風格的偵探角色圖片,並要求模型讓他在不同的場景中行走。測試結果令人滿意,無論是穿梭在雨中的倫敦街頭,還是在昏暗的酒館內點燃火柴,該角色的服裝特徵、臉部輪廓與手繪風格都維持了極高的角色一致性。這對於需要產出連續劇集或長篇動畫的創作者來說,無疑是一大福音。
Gemini Omni 與過往單一模態工具有什麼不同?
單看文字描述或許還不夠具體,為此我們整理了一份比較表格,讓您一目了然全新技術究竟帶來了哪些技術躍進。
| 評測項目 | Gemini Omni (2026 最新版) | 傳統單一模態 AI 工具 |
|---|---|---|
| 輸入彈性 | 支援文字、圖片、音訊、影片同步混合輸入 | 通常僅支援單一輸入 (如純文字生成影片) |
| 角色一致性 | 極高,具備長鏡頭穩定性與特徵鎖定功能 | 較差,容易出現角色變形或風格跳躍 |
| 音畫同步處理 | 原生支援,自動將畫面動作與音軌節奏對齊 | 無原生支援,需依賴第三方軟體人工對位 |
| 自然語言修改 | 可使用中文指令直接對既有影片進行區域修改 | 通常需要重新輸入完整的提示詞並重新生成 |
如何在您的工作流程中整合 Google Flow 與 AI 影片編輯?
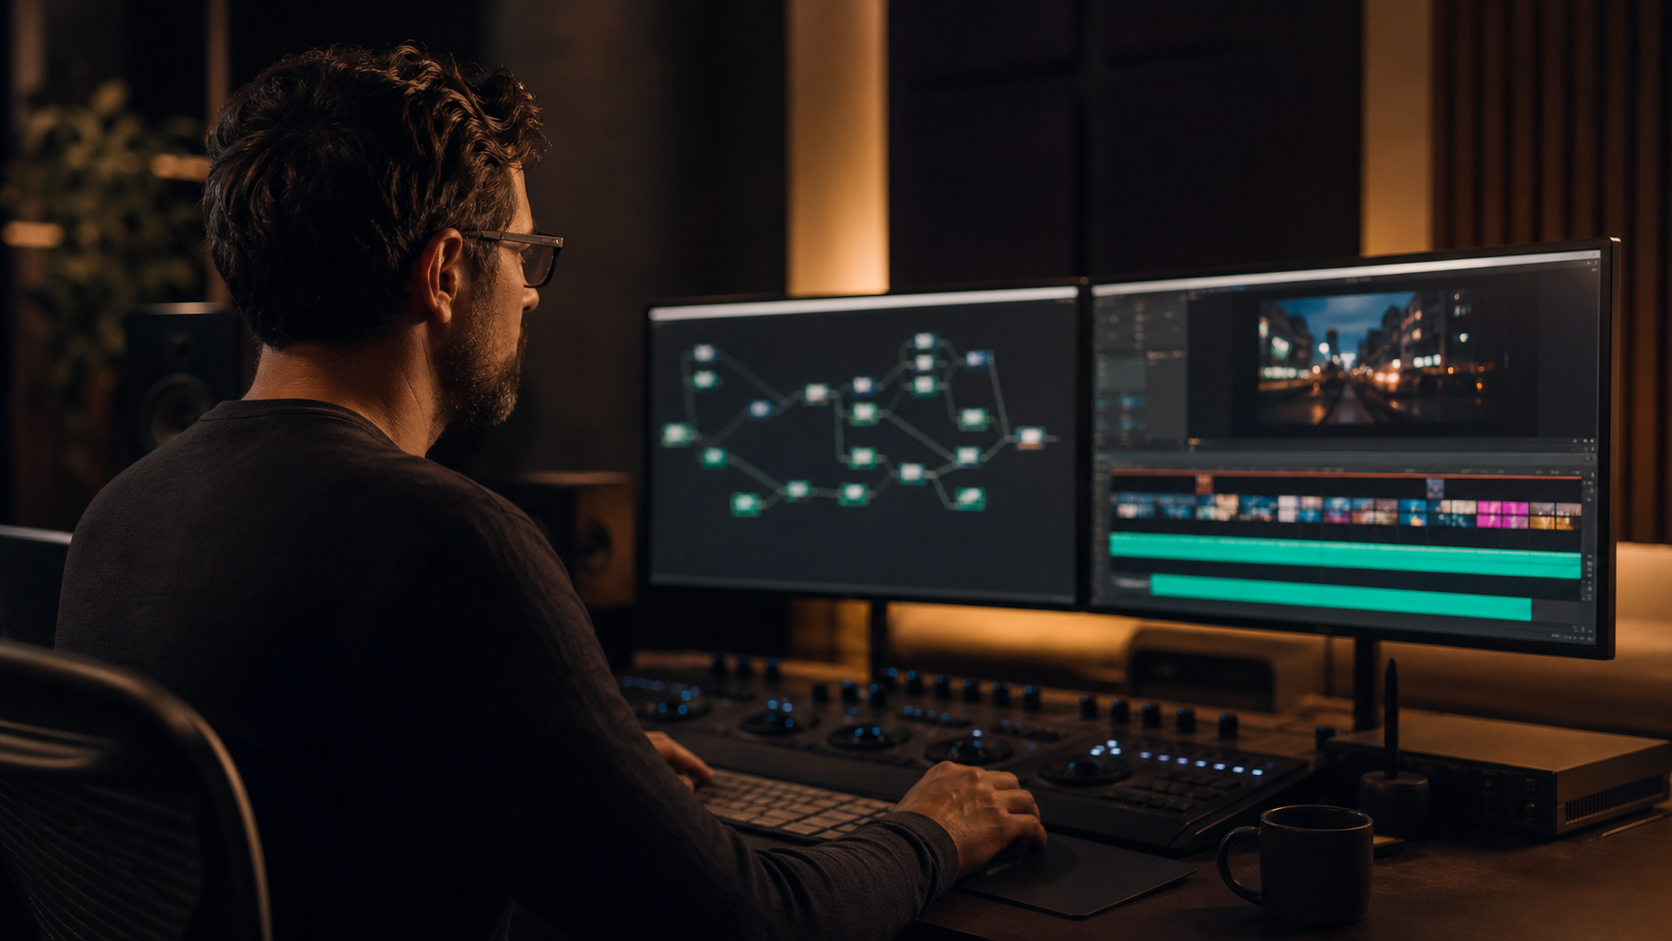
強大的模型也需要優良的介面來發揮。Google 在發表模型之餘,也同步展示了基於節點式設計的 Google Flow 介面。這項工具不僅視覺化了複雜的多模態生成過程,更讓影片製作變得像拼圖一樣直覺。
自然語言驅動的修改流程是如何運作的?
透過這項整合,我們不再需要具備深厚的程式碼背景。若要修改畫面中的某個特定元素,您只需要圈選該區域,並輸入自然語言。例如,我們框選影片中的跑車,輸入「將這輛車換成紅色的敞篷車,並在車頂加上積雪」,系統便會自動分析上下文,以無痕的方式完成替換。以下是我們建議的工作流程:
- 素材匯入與節點建立:將您準備好的語音旁白與靜態概念圖拖曳至畫布中,建立初始節點。
- 連結與設定:使用箭頭將這些素材節點連接至核心運算區域,並在屬性欄中輸入場景氛圍的文字設定。
- 預覽與生成:系統會即時產出低解析度的預覽,確認分鏡無誤後,再輸出高畫質的完整片段。
- 局部微調:若對某個分鏡不滿意,利用自然語言直接對該節點下達修改指令,無須重新運算整部影片。
導入 Gemini Omni 進行商業使用前,有哪些不可不知的著作權風險?
雖然尖端技術帶來了前所未有的便利,但在將其應用於商業專案之前,我們必須正視潛在的法律與著作權風險。自動生成內容的版權歸屬,在世界各國的法規中仍處於持續演進的階段。
版權歸屬與原創素材為何如此重要?
根據目前的討論與案例,若您使用受版權保護的他人圖片作為系統的輸入源,生成的衍生作品極有可能構成侵權。因此,我們強烈建議企業在進行商業操作時,務必確保所有作為提示詞的素材(包含影像與音訊)皆擁有合法授權或屬於完全原創。同時,妥善保存所有輸入素材與生成過程的紀錄,將有助於在未來的著作權爭議中提供有力的證明。
常見問題與解答 (Frequently Asked Questions)
Gemini Omni 是什麼?它如何改變 AI 影片生成流程?
這款工具是 Google 於 2026 年 5 月推出的多模態 AI,能將文字、圖片、影片與音訊等不同輸入源結合,生成高品質影片。它打破了過去依賴單一輸入的限制,讓創作者可以同時處理多種媒體素材,大幅縮減後期製作時間。
如何利用它進行高品質的圖片轉影片?
使用者只需上傳一張或多張靜態圖片,並加上描述動作或場景變化的文字提示詞,模型就能在保持高度角色一致性的前提下,將圖片轉換為流暢的動態影像。
這款影片編輯功能支援繁體中文嗎?
完全支援。根據我們的實測,您可以直接使用繁體中文的自然語言指令(例如「將背景調整為黃昏的光影」),直接修改既有作品的運鏡、光影或局部元素。
什麼是 Google Flow?它與影片生成有何關聯?
它是一個視覺化的工作流程介面,讓創作者可以透過拖曳節點的方式,將文字、音訊、圖片等不同素材串接。它能作為強大的核心運算引擎介面,幫助用戶更直觀地管理複雜的生成式專案。
使用這類工具生成的影片有著作權風險嗎?
商業使用時仍需特別注意。若您輸入的圖片或音訊含有他出版權,生成的內容會有侵權疑慮。建議優先使用無版權素材或原創內容進行混合生成,並妥善保存生成紀錄,以降低商業使用的法律風險。