TinyML 邊緣運算指南:如何讓深度學習模型在物聯網感測器進行本地推理?
什麼是 TinyML?為什麼我們需要將深度學習移到邊緣微控制器上?
雲端運算遇到了哪些無法解決的頻寬與延遲瓶頸?
在物聯網(IoT)時代,成千上萬的感測器每天產生海量的數據。傳統上,這些數據必須被傳送到雲端伺服器進行處理與分析。然而,這種雲端運算架構面臨著嚴重的物理限制。首先是傳輸延遲,在自動駕駛、智慧工廠或醫療監控等即時應用中,數百毫秒的延遲可能導致嚴重的安全事故。其次,將所有原始數據上傳至雲端會消耗大量的網路頻寬,對於部署在偏遠地區或使用行動網路的設備來說,頻寬成本高得令人難以承受。此外,雲端傳輸也伴隨著數據洩露與隱私安全的風險。
根據我們團隊在智慧硬體專案中的實戰經驗,當數千台感測器同時上傳高頻振動數據時,雲端伺服器的頻寬開銷與 API 調用費用呈指數級增長。這使我們意識到,必須在硬體終端進行本地推理(Local Inference),才能真正實現具備成本效益且即時反應的邊緣 AI 系統。
什麼是微型機器學習(TinyML)?它的核心定義與運作邏輯是什麼?
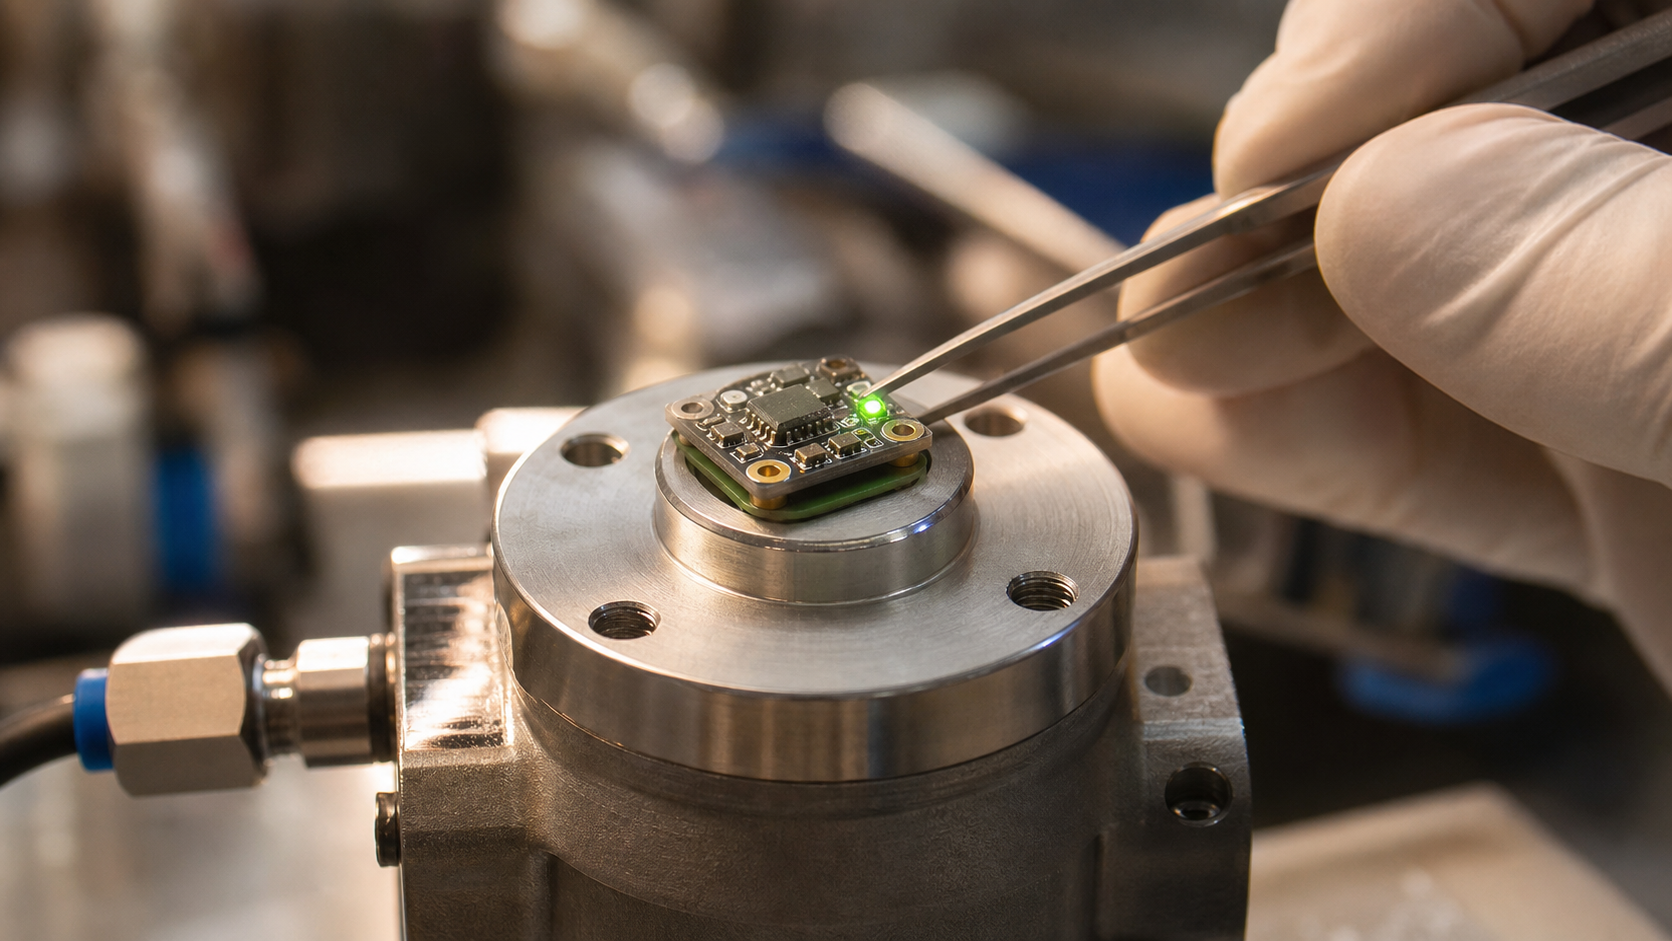
TinyML(微型機器學習)是邊緣運算 (Edge AI) 的一個新興分支。它專注於在功耗僅為毫瓦(milliwatt)級別、且資源極度受限的硬體設備(如微控制器 MCU)上運行機器學習模型。傳統的深度學習模型(如 ResNet 或 GPT 家族)動輒需要數百 MB 甚至數 GB 的記憶體與強大的 GPU 支持,而典型的微控制器(如 ARM Cortex-M 系列)往往只有數十 KB 到數百 KB 的靜態隨機存取記憶體(SRAM)以及不到 1MB 的快閃記憶體(Flash)。
TinyML 的核心目標,就是將原本龐大的神經網路模型,壓縮至能夠塞進這些「微型晶片」的大小,並在本地高效執行推理任務。這意味著設備可以在沒有網路連接的情況下,自主感知、分析並做出決策。這項技術徹底改變了物聯網設備的定位,讓微型感測器不再只是被動的數據收集器,而是擁有獨立思考能力的「智慧大腦」。
TinyML 如何在資源極度受限的微型感測器上運行?
深度學習模型是如何被「瘦身」的?解析模型量化與剪枝技術
要將動輒數百萬參數的深度學習模型放進微控制器,必須採用先進的模型壓縮技術。我們在實際開發中,主要依賴以下兩種核心方法:
- 模型量化(Quantization):這是最有效的瘦身手段。通常,深度學習模型的權重和激活值都是使用 32 位元浮點數(FP32)來表示。量化技術則是將這些數值轉換為 8 位元整數(INT8)或甚至更低位元(如 INT4)。這能直接將模型體積縮減至原來的四分之一,同時大幅加快運算速度,因為微控制器處理整數運算的效率遠高於浮點數。
- 模型剪枝(Pruning):在訓練過程中,神經網路中許多權重接近於零,對最終預測結果的貢獻微乎其微。剪枝技術就是找出並移除這些「冗餘」的連接與神經元,從而減少計算量並節省記憶體空間。
- 知識蒸餾(Knowledge Distillation):利用一個大型、準確度高的「教師模型」來指導一個結構簡單的「學生模型」進行訓練,使小模型能繼承大模型的特徵提取能力,以極小的體積達到相近的精準度。
有哪些主流的 TinyML 軟硬體框架可以支援邊緣推理?
目前市面上已經有多個成熟的開源與商業框架,協助開發者進行 TinyML 的模型轉換與部署。在選擇框架時,需要根據目標硬體平台、支援的算子(Operators)以及易用性進行評估。以下是我們整理的主流框架比較表:
| 框架名稱 | 主要開發者/組織 | 適用硬體平台 | 核心優勢 | 適用場景 |
|---|---|---|---|---|
| TensorFlow Lite Micro | ARM Cortex-M, ESP32, Xtensa 等 | 生態系龐大,與 TensorFlow 無縫整合,算子庫豐富 | 通用邊緣 AI 研發與跨平台部署 | |
| Edge Impulse | Edge Impulse 公司 | 多數主流開發板(Arduino, STM32 等) | 無程式碼/低程式碼 Web 介面,自動化模型最佳化與部署 | 快速原型開發、感測器數據分析 |
| STM32Cube.AI | STMicroelectronics | STM32 全系列微控制器 | 針對 STM32 晶片進行硬體級深度優化,執行效率極高 | 工業級 STM32 硬體產品部署 |
當我們為一家製造業客戶設計機台預測性維護系統時,我們測試了 TensorFlow Lite Micro 與 Edge Impulse。雖然 TFLite Micro 給予了我們更多的底層控制權,但 Edge Impulse 在處理時間序列(Time-series)感測器數據時的自動特徵提取功能,大幅縮短了我們的開發週期。這說明了工具的選擇往往取決於專案的時間限制與團隊的硬體背景。
邊緣運算與 TinyML 在 2026 年迎來了哪些技術突破?
微控制器硬體(MCU)如何內建神經網路加速器(NPU)?
近年來,半導體廠商開始在微控制器中整合專屬的硬體加速單元。例如,ARM 推出帶有 Helium 技術的 Cortex-M55 與 Cortex-M85 核心,並搭配 Ethos-U55/U65 微型 NPU(神經網路處理器)。這種「MCU + NPU」的架喚,讓微型晶片在處理卷積神經網路(CNN)等複雜矩陣運算時,效能提升了數十倍甚至上百倍,而功耗卻依然保持在極低水準。這使得在本地進行即時語音辨識、物件偵測等過去難以想像的任務成為可能。
如何利用 TinyML 進行物聯網設備的本地推理與即時決策?
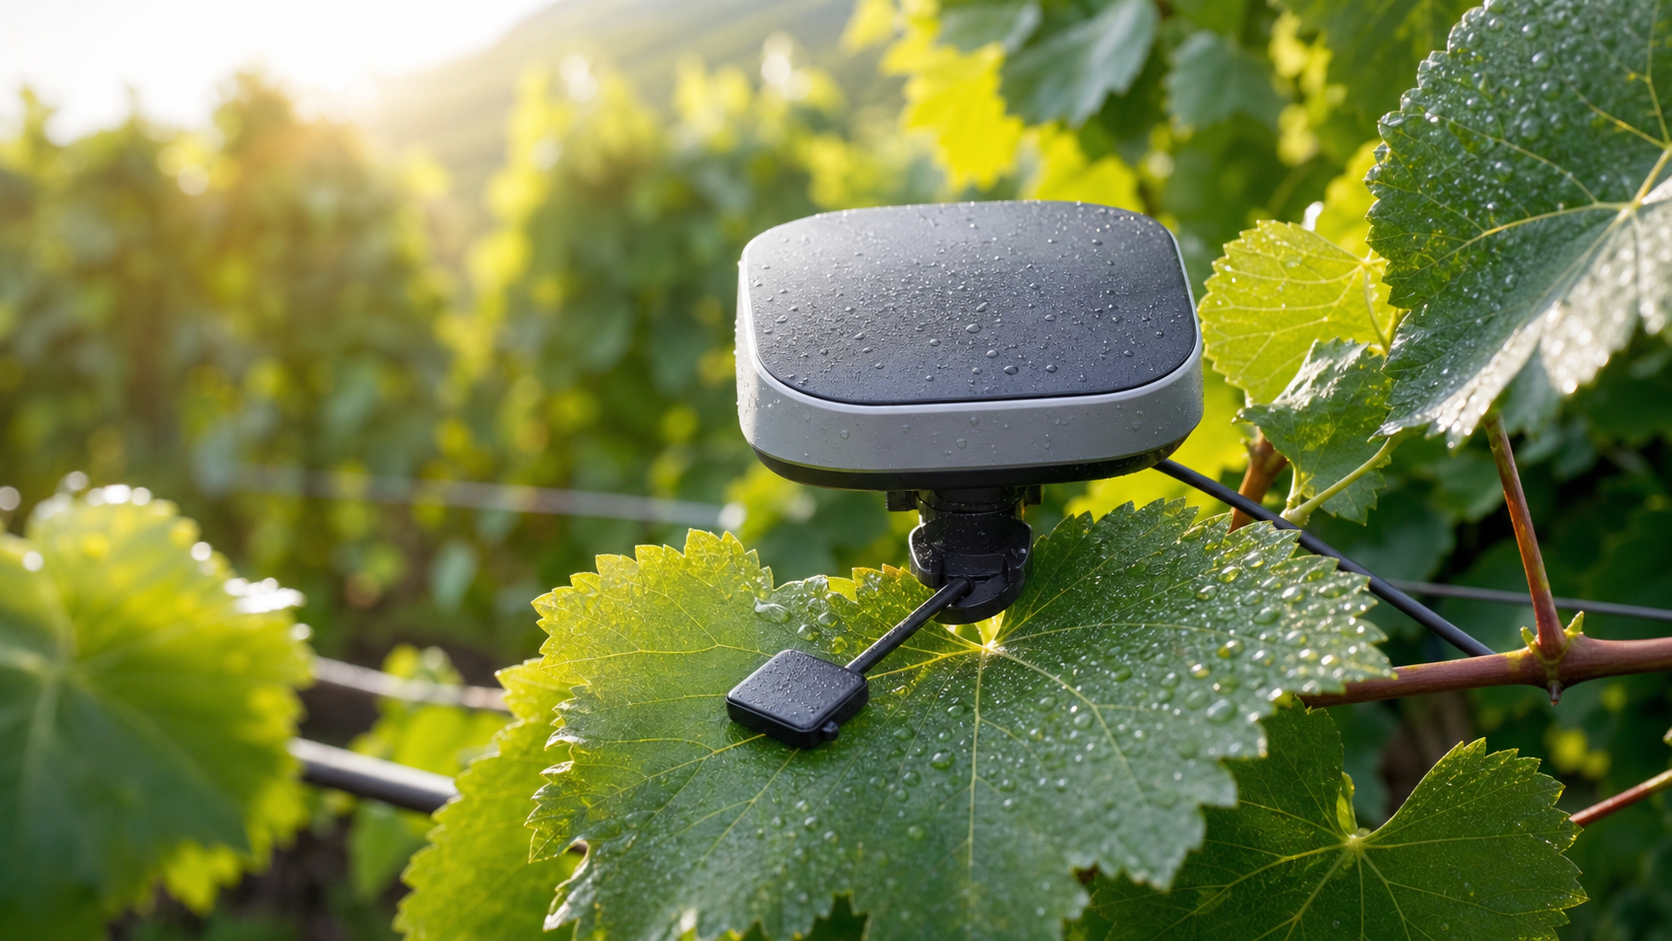
結合了新型硬體加速晶片,TinyML 在物聯網的應用更加靈活。設備在採集到物理信號(如溫度、振動、光信號)後,不需要等待網路打包發送,而是直接在感測器端進行特徵提取與神經網路推理。例如,智慧電表可以在本地偵測異常耗電模式並立即切斷電源;智慧農業感測器則能在本地辨識作物病蟲害,僅在發現異常時向農場主發送警報。這種「本地推理、僅回傳警報」的模式,將物聯網系統的整體網路負載降低了 95% 以上。
我們在實際部署 TinyML 時遇到了哪些挑戰與解決方案?
在微型設備上部署 AI 模型時,如何克服記憶體與靜態 RAM(SRAM)不足的困境?
在 TinyML 開發中,最常見的「鬼故事」就是 Out of Memory (OOM)。微控制器的 SRAM 通常非常珍貴,例如僅有 256KB。當你的模型權重加上推理時的臨時張量(Tensor Arena)超過這個限制,系統就會直接崩潰。為了解決這個問題,開發者必須採取極其精細的記憶體管理策略:
- 調優張量工作區(Tensor Arena Size):精確計算模型推理時所需的最大臨時記憶體,並在程式碼中進行靜態配置,避免動態記憶體分配(Dynamic Allocation)帶來的破碎化。
- 算子融合(Operator Fusion):在編譯模型時,將多個連續的神經網路層(例如 Conv2D + BatchNorm + ReLU)合併為單個運算,以減少中間步驟產生的臨時數據。
- 使用片外 Flash 儲存權重:將唯讀的模型權重儲存在外部 Flash 中,僅在運算時將當前層的權重加載到 SRAM,完成後立即釋放。
我們團隊在智慧硬體專案中的實戰經驗與調優技巧有哪些?
當我們嘗試在一個基於 ESP32 的穿戴式健康監測設備上部署心率異常分析模型時,最初的版本因為使用了浮點運算,導致設備發熱嚴重且電池壽命僅能維持 4 小時。隨後,我們進行了全整數(Full Integer)量化,將所有浮點運算改為 INT8。這不僅使推理速度提升了 5.8 倍,電池壽命也延長到了 3 天。這個經驗告訴我們,在邊緣端,功耗與速度的優化往往比追求極致的準確度更具商業價值。
TinyML 的真實應用場景有哪些?看微型感測器如何顛覆傳統產業
智慧製造中的預測性維護:如何利用振動感測器在本地偵測機台異常?
在智慧工廠中,馬達或齒輪箱的損壞會導致昂貴的停機成本。透過在馬達外殼安裝整合了 TinyML 模型的振動感測器,系統可以採集高頻加速度數據,並在本地運行快速傅立葉變換(FFT)與異常偵測模型。一旦發現異常的振動頻率特徵(例如軸承磨損),感測器會立即發出警報。這使得工廠能在設備完全故障前安排維護,防患於未然,同時避免了將大量原始振動波形數據傳輸至雲端的昂貴網路費用。
智慧家居與穿戴式裝置:如何實現極低功耗的語音喚醒與手勢辨識?
從智慧音箱的「喚醒詞偵測」(Keyword Spotting)到智慧手錶的抬手顯示,TinyML 早已融入我們的日常生活。這些裝置內建的超低功耗微處理器會持續監聽麥克風或讀取慣性測量單元(IMU)感測器數據。只有當 TinyML 模型在本地確認偵測到特定的語音指令(如 “Hey Siri”)或特定的手勢時,才會喚醒主處理器進行後續的複雜處理。這種分層運作架構是現代行動裝置能夠維持數天甚至數週續航力的不二法門。
關於 TinyML 與邊緣運算的常見問答(FAQ)
- Q1: TinyML 和一般的邊緣 AI (Edge AI) 有什麼不同?
- 邊緣 AI 是一個廣義的概念,涵蓋所有在終端設備(包括高效能的邊緣伺服器、NVIDIA Jetson 等單板電腦)上運行的 AI 應用。而 TinyML 則是邊緣 AI 的極致子集,專門指在功耗低於 1 毫瓦、硬體資源極度受限的微控制器(MCU)上運行的機器學習技術。
- Q2: 將模型量化為 INT8 會對預測準確度造成很大影響嗎?
- 在大多數情況下,經過良好訓練與校準的模型在量化為 INT8 後,精準度的損失非常微小(通常低於 1% 至 2%)。這是因為深度學習模型本身具有很強的魯棒性,且量化過程中會使用校準數據集來最大程度保留特徵資訊。
- Q3: TinyML 設備通常使用什麼樣的電池?能維持多久?
- 由於 TinyML 設備的功耗極低,它們通常可以使用鈕扣電池(如 CR2032)或小型鋰電池供電。搭配休眠機制與事件觸發的推理模式,單次充電或單顆電池通常可以維持數月甚至數年之久。
- Q4: 開發 TinyML 專案一定要具備硬體工程背景嗎?
- 不一定。現在有了如 Edge Impulse、Google Teachable Machine 等友好的工具,軟體開發者或資料科學家可以非常輕鬆地訓練模型並生成可直接燒錄的 C++ 函式庫。然而,具備基本的嵌入式系統知識(如瞭解暫存器、SRAM、GPIO 與串列通訊)能讓您在進行記憶體優化與除錯時更加得心應手。
- Q5: 為什麼 TinyML 對保護使用者隱私特別有幫助?
- 因為所有的數據採集、預處理與 AI 推理都在感測器本地完成,原始的敏感數據(如人臉影像、語音錄音、健康數據)不需要上傳至雲端伺服器。只有去識別化後的推斷結果或警報才會對外發送,這從根本上杜絕了傳輸過程與雲端資料庫被駭的隱私風險。